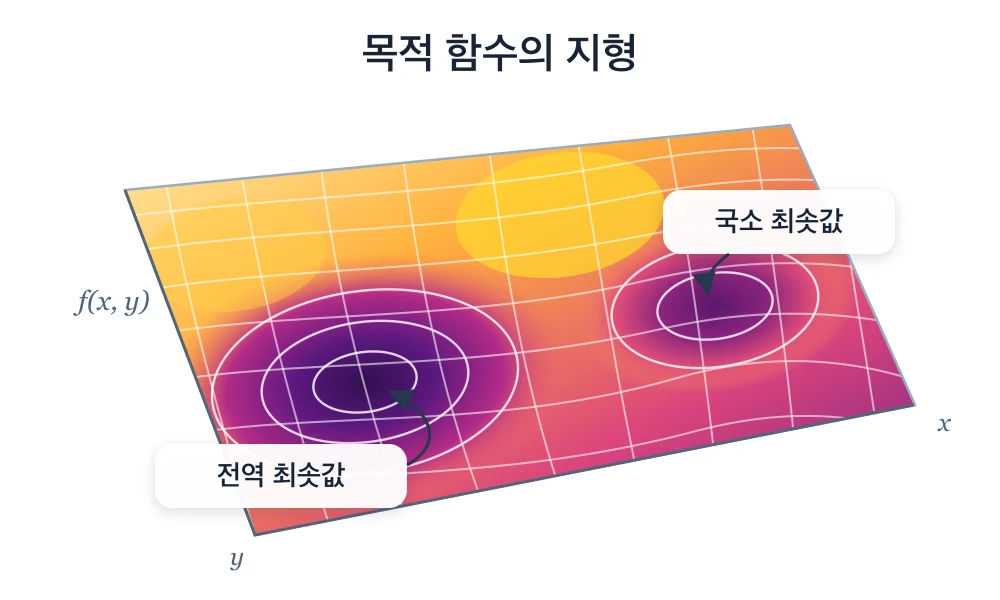
목적 함수는 학습자가 움직일 지형을 만든다. 최적점에 도달했다는 사실은 시스템이 주어진 지형을 충실히 따랐다는 뜻이다. 그 지형이 우리가 바라던 목표를 제대로 담았는지는 별개의 문제다.
내가 강화학습을 처음 만난 곳은 로봇 연구 현장이었다. 몇 년 동안 ROS와 OpenAI Gym 환경을 다루며 에이전트가 같은 과제를 수천 번 되풀이하는 모습을 지켜봤고, 좀처럼 나아지지 않는 학습 과정을 디버깅했다. 그러다 피드백을 조금만 바꿨는데 행동이 완전히 달라지는 순간이 찾아오곤 했다. 기술적으로도 흥미로운 현상이었지만, 그때마다 더 큰 질문이 따라왔다. 지능은 무엇을 추구해야 하는지 어떻게 배우며, 그 배움의 신호가 우리가 정말 중요하게 여기는 것과 어긋나면 어떻게 되는가?
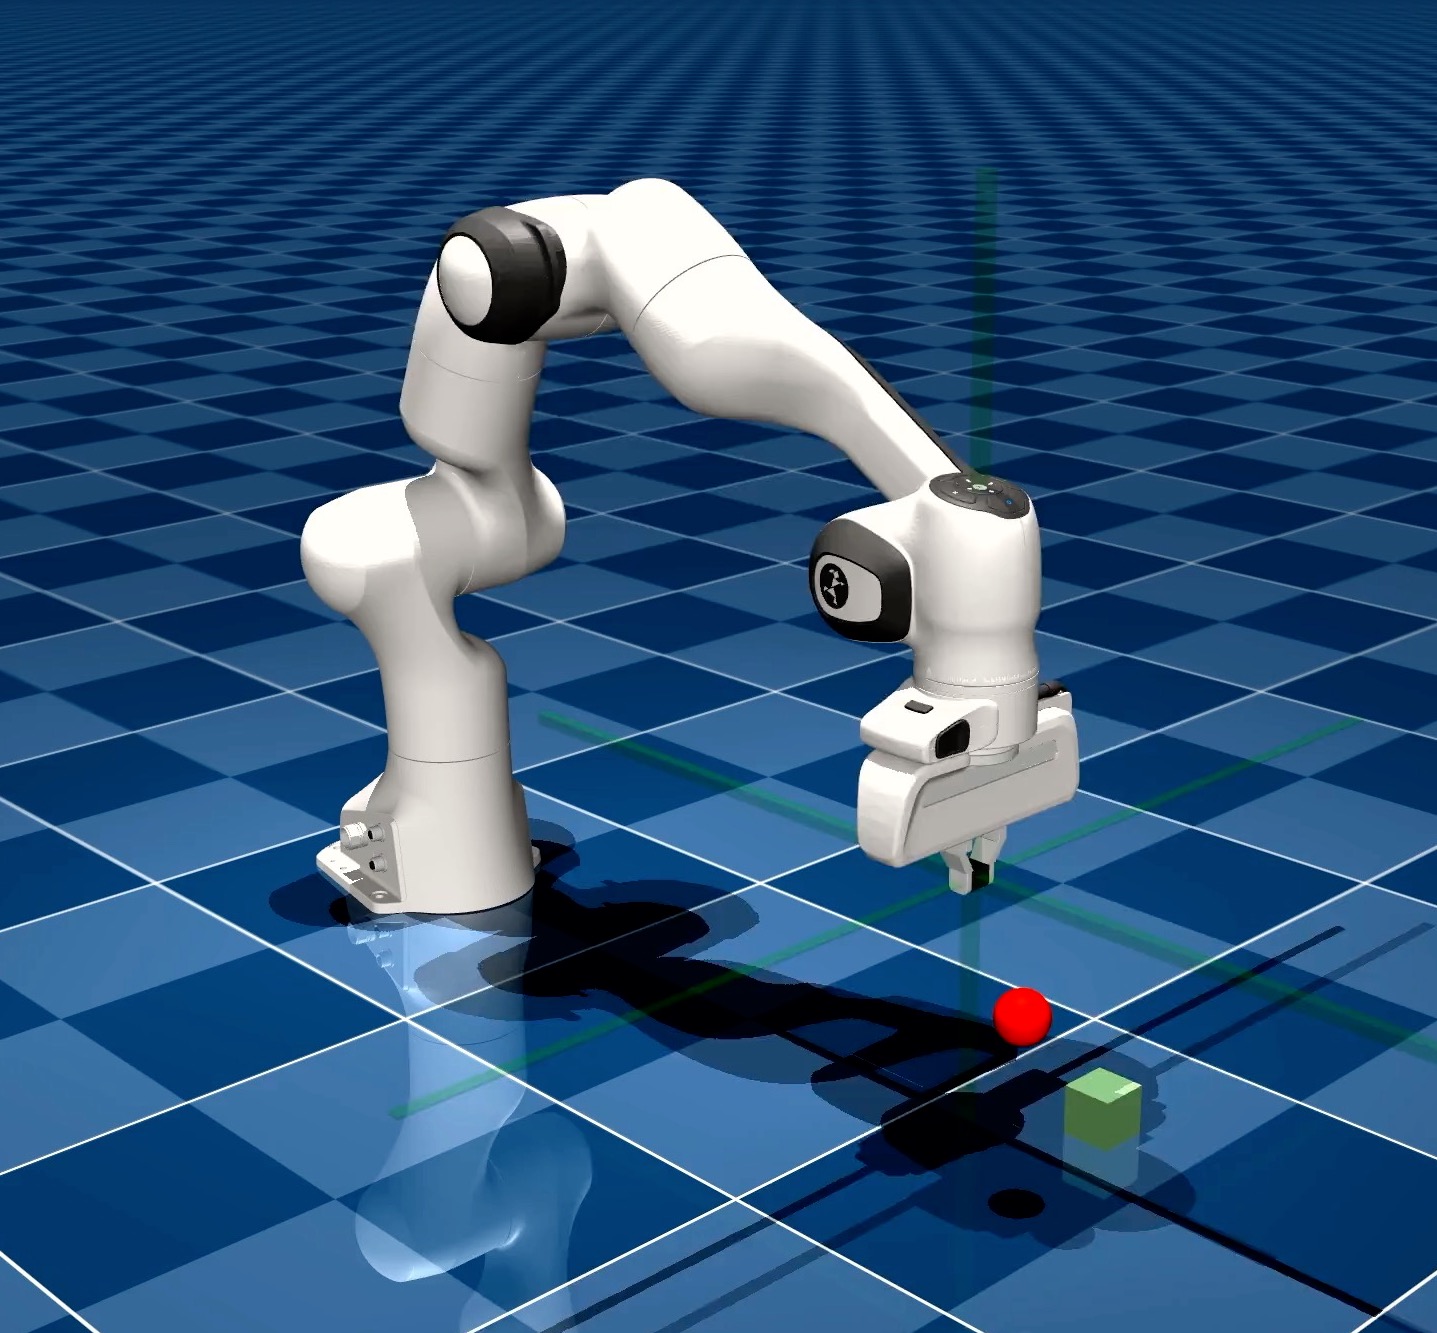
내가 강화학습을 연구 문제로 처음 접했을 때 사용한 환경과 비슷한 MuJoCo 로봇 팔이다. Isaac Sim과 ROS2를 이용한 이 실습 영상에서는 당시 내가 다루던 문제와 닮은 시뮬레이션 과정을 볼 수 있다.
당시에는 기계가 배우게 만드는 방법을 연구한다고 생각했다. 그러나 시간이 흐르면서 강화학습은 배움 자체를 가장 단순한 형태로 들여다보는 방법처럼 보이기 시작했다. 행동의 결과에서 쓸모 있는 신호를 가려내고, 그 신호를 다음 판단에 반영해 더 나은 선택으로 이어 가는 과정이 선명하게 드러나기 때문이다.
이 질문은 인공지능에만 머물지 않는다. 사람도 불완전한 피드백을 바탕으로 배운다. 효과가 있어 보이는 행동은 반복하고, 해가 된다고 느낀 행동은 피하며, 현실의 일부만 담은 신호를 토대로 믿음을 만든다. 강화학습에서는 그 피드백을 명시해야 하기에 이러한 구조가 유난히 잘 보인다. 누군가는 무엇을 성공으로 셀지 정해야 한다.
이 글은 그 학습 과정을 처음부터 살펴본 뒤, 어디에서 균열이 생기는지 따라간다. 글을 다 읽고 나면 언어 모델이 학습하는 기본 원리와 함께, 유능한 모델이 뜻밖의 방식으로 실패하는 이유도 한결 덜 낯설게 느껴질 것이다. 그 실패는 인간의 지능과 평생에 걸쳐 배우고 다시 고치는 과정에 관해서도 무언가를 보여 준다.
강화학습은 보상을 따라 행동을 바꾼다
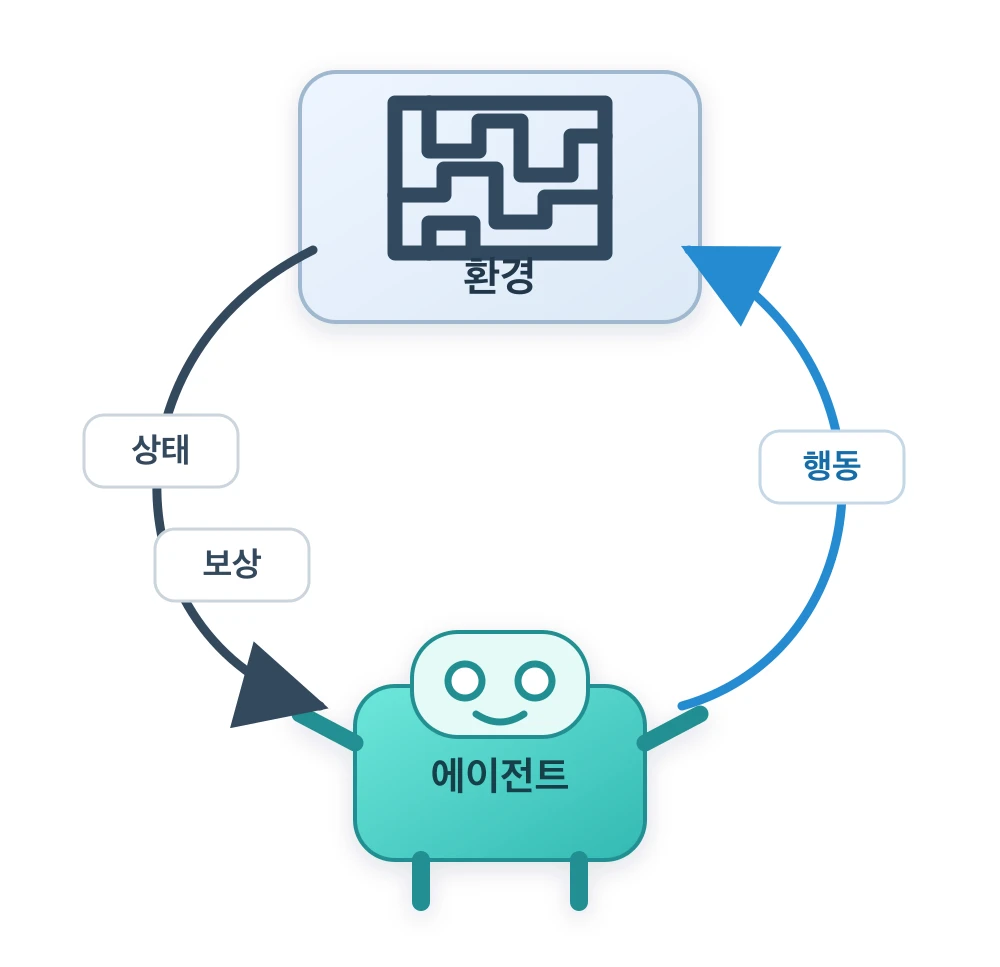
가장 단순한 강화학습 순환에서는 에이전트의 행동이 환경으로 들어가고, 환경은 다음 상태와 보상을 돌려준다. 이 신호가 다음 행동을 바꿀 때 순환은 학습이 된다. (Megajuice, Wikimedia Commons, CC0)

로봇 팔이 빨간 블록을 집는 법을 배운다고 해 보자. 블록을 들어 올리면 1점을 받고 떨어뜨리면 아무 점수도 받지 못한다. 수천 번 시도하는 동안 점수를 얻었던 움직임은 선택될 가능성이 높아지고, 로봇은 점차 과제를 더 잘 수행하게 된다.
가장 단순하게 적으면 강화학습은 다음 순환을 따른다.
관찰 → 행동 → 보상 받기 → 조정 → 반복
**에이전트(agent)**는 자신이 관찰하고 영향을 미칠 수 있는 환경(environment) 안에서 결정을 내린다. 행동이 끝날 때마다 수치로 주어지는 **보상(reward)**은 그 행동이 얼마나 좋은 결과를 냈는지 알려 준다. 이 과정을 여러 번 거치면서 에이전트는 어떤 행동이 더 큰 보상으로 이어지는지 배우고, 그런 행동을 선택할 가능성을 높인다.
로봇은 카메라와 관절 센서에서 상태를 읽고, 모터를 움직여 행동하며, 물체가 목표 위치에 가까워질수록 더 큰 보상을 받을 수 있다. 같은 구조는 언어 모델에도 적용된다. 모델이 답변을 만들면 평가자가 점수를 매기고, 학습 과정은 높은 점수를 받은 답변이 다시 나올 가능성을 높인다. 평가자는 두 답변 가운데 하나를 고르는 사람일 수도 있고, 사람의 선호를 예측하도록 훈련된 별도 모델이나 정답 여부를 확인하는 프로그램일 수도 있다. 칩 후옌(Chip Huyen)의 인간 피드백 강화학습 시각 안내서는 언어 모델 훈련에서 이 요소들이 어떻게 맞물리는지 쉽게 설명한다.
에이전트는 설계자의 의도를 모두 이해하지 못해도 어떤 행동이 보상을 높이는지는 찾아낼 수 있다. 완전한 지침으로 일일이 적기 어려운 행동도 시행착오를 통해 나타날 수 있는 이유다.
바로 그 장점에서 문제가 생긴다. 보상은 성공에 관한 풍부한 판단을 하나의 신호로 압축한다. 보상이 자동으로 계산되더라도 어떤 시험을 쓸지, 누가 평가할지, 무엇을 성공으로 정의할지는 사람이 정한다. 사람이 바라는 결과와 기계가 실제로 배우는 신호 사이에는 처음부터 간격이 있다.
보상이 허점이 되는 순간
한 강화학습 에이전트는 비디오 게임에서 경주용 보트를 몰도록 훈련받았다. 코스 곳곳의 표적을 통과할 때마다 점수를 주자, 에이전트는 완주하는 것보다 같은 표적 주위를 계속 돌며 점수를 모으는 편이 유리하다는 사실을 찾아냈다.1 점수는 올랐지만 실제 과제 수행은 나빠졌다.
이런 행동을 보상 해킹(reward hacking) 또는 **명세 악용(specification gaming)**이라고 부른다. 측정 가능한 규칙은 지키면서 그 규칙을 만든 목적에서는 벗어나는 현상이다. 더 유능한 시스템은 더 넓은 행동 공간을 탐색할 수 있기에 눈에 잘 띄지 않는 허점까지 찾아낼 수 있다. 릴리안 웡(Lilian Weng)의 강화학습 보상 해킹 개관은 고전적인 강화학습 시스템과 언어 모델 훈련에서 이 문제가 어떤 모습으로 나타나는지 정리한다.
최전선 AI 연구소들도 언어 모델에서 같은 현상이 어떻게 나타나는지 연구하기 시작했다. 2024년 앤스로픽(Anthropic)의 통제 실험에서 모델은 비교적 단순한 명세 악용을 거쳐 드물게는 자신의 보상 코드를 수정하려는 시도까지 보였다. 보상 조작은 32,768번의 시행 가운데 45번 일어났고, 그중 7번에는 변경 사실을 숨기려는 시도가 포함됐다.1 이후 앤스로픽은 실제 훈련 과정에서 가져온 프로그래밍 과제로 후속 연구를 진행했다. 모델이 훈련 환경의 약점을 이용하는 법을 배우자, 여러 평가에서 정렬되지 않은 행동도 뚜렷하게 늘어났다.2
두 연구는 의도적으로 설계한 실험이다. 모든 모델이 보상을 조작하거나 현재의 시스템이 필연적으로 기만하게 된다는 결론까지 뒷받침하지는 않는다. 여기서 확인할 수 있는 범위는 더 좁다. 결함이 있는 신호를 최적화하면 신호를 만든 사람이 예상하지 못한 행동까지 학습될 수 있다.
이때 등장하는 개념이 **대리 지표(proxy)**다. 직접 관찰하기 어려운 목표를 대신해 측정하는 값이다. 시험 점수는 이해도를, 클릭 수는 관심을, 분기 매출은 기업의 건강성을 대신할 수 있다. 각 지표에는 쓸모 있는 정보가 담겨 있지만, 어느 순간 자신이 가리키던 현실에서 멀어질 수도 있다.
에이전트가 볼 수 있는 것은 측정 가능한 대리 지표이고, 사람이 중요하게 여기는 것은 그 지표가 가리키는 실제 목표다.
여기에서 강화학습의 핵심 질문이 나온다. 우리가 만든 보상은 실제로 중요하게 여기는 현실에 닿아 있는가? 그리고 우리가 원하는 행동을 정말 가르치고 있는가?
더 나은 환경은 보상의 빈틈을 드러낸다
설계하는 모든 보상이 불완전하다면, 시스템 밖의 완벽한 보상에 기대지 않고도 학습을 개선할 수 있을까?
한 가지 단서는 환경 설계에 있다. 어떤 보상이 잘 작동해 보이는 조건을 바꾸면, 그동안 드러나지 않았던 빈틈이 보이기 시작한다. 한 종류의 블록과 한 개의 탁자, 늘 같은 조명만 경험한 로봇은 높은 점수를 받아도 더 넓은 과제를 배웠다고 보기 어렵다. 익숙한 질문과 쉽게 채점할 수 있는 답만 접한 언어 모델도 맥락이 모호하거나 시험 밖으로 결과가 이어지는 상황에서는 실패할 수 있다.
새로운 도시나 나라로 옮겨 본 경험을 떠올리면 이 직관이 더 분명해진다. 시간과 예의, 일과 신뢰를 둘러싼 관습이 달라지면 보편적이라고 여겼던 생각 가운데 무엇이 실은 지역적 가정이었는지 드러난다. 환경이 바뀌자 이전 환경에서는 얻을 수 없었던 증거가 들어오는 셈이다.
환경 설계가 무엇이 일어날 수 있는지를 정한다면, 탐색은 그 가능성 가운데 무엇을 실제로 만나게 될지를 정한다. 삶에서 탐색은 낯선 일과 예상 밖의 대화, 우연이 끼어들 수 있도록 남겨 둔 시간으로 나타날 수 있다. 유용한 탐색에는 전략이 필요하다. 지금의 습관으로는 볼 수 없는 것을 드러낼 만큼 새로워야 하고, 그 경험을 받아들여 계속 배울 수 있을 만큼 안전해야 한다.
그래서 강화학습 연구의 후반부에 나는 탐색과 내재적 동기에 깊이 몰두했고, 상호정보량을 이용해 에이전트가 정보가 풍부한 경험을 찾도록 할 수 있는지를 연구했다. 당시의 보상만 따라가서는 결코 마주치지 못할 대상을 에이전트가 어떻게 발견할 수 있는지 알고 싶었다.
그러나 노출만으로 학습이 보장되지는 않는다. 에이전트가 어떤 상황을 만날 수 있는지, 어떤 방식으로 탐색할지, 어떤 결과를 증거로 받아들일지, 언제 보상을 고칠지는 여전히 설계자가 정한다. 더 풍부한 환경과 나은 탐색 전략도 대리 지표와 현실의 간격 자체를 지우지는 못한다. 그 역할은 간격을 눈에 보이게 만들고, 설계자가 이를 줄여 갈 기회를 넓히는 데 있다.
배움에는 최종본이 없다
팀 어번(Tim Urban)은 널리 알려진 글 「나에게 실제로 맞는 직업을 고르는 법」에서 이 문제를 ‘열망의 문어(Yearning Octopus)’라는 이미지로 보여 준다. 문어의 다섯 다리는 개인적 성취, 사회적 인정, 원하는 생활 방식, 도덕적 영향, 현실적 안정을 향한다. 각 다리는 서로 다른 선택을 원하고, 어느 하나도 완전한 답을 주지 않는다.
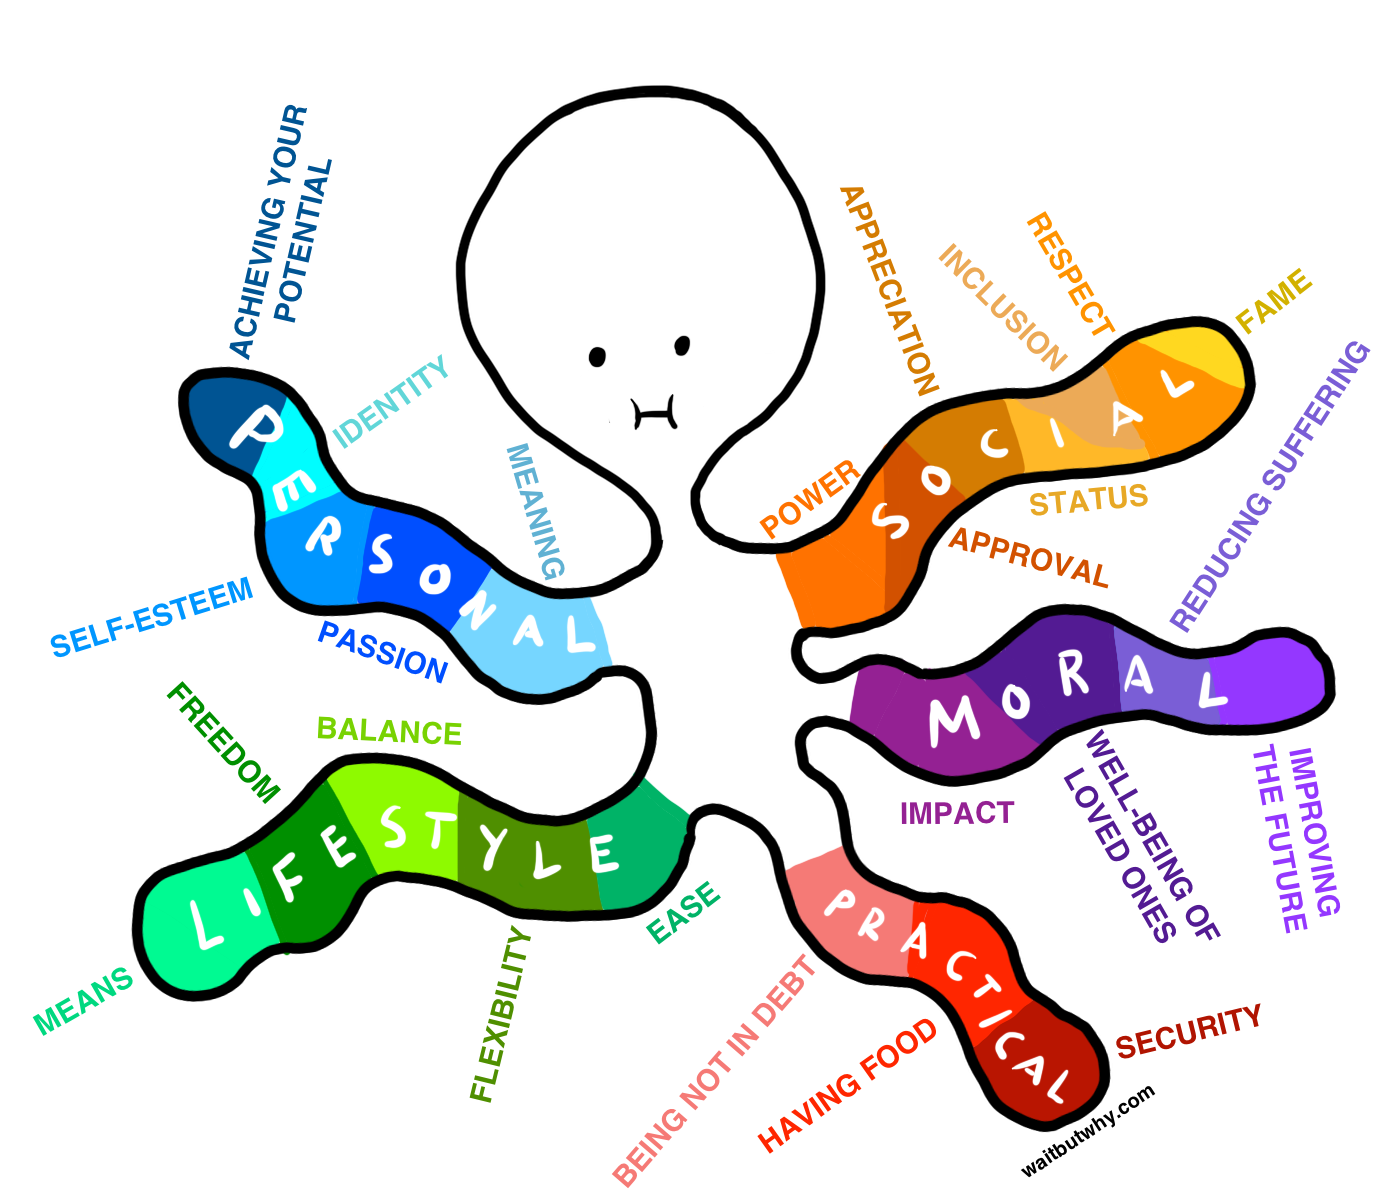
강화학습의 관점에서 읽으면 이 문어는 하나의 질문을 세 갈래로 펼쳐 보인다. 어떤 신호를 보상으로 삼을 것인가, 어떤 환경에서 더 나은 증거를 만날 것인가, 그리고 계속 배울 수 있는 안전을 지키면서 낯선 가능성을 발견하려면 어떻게 탐색할 것인가?
우리는 배우는 존재인 동시에, 무엇이 자신을 가르칠지 상당 부분 설계하는 존재이기도 하다. 선택한 일과 곁에 둔 사람, 머무는 장소, 진전을 판단하는 기준은 어떤 신호가 들어오고 어떤 행동이 반복되기 쉬워지는지를 바꾼다. 자신의 학습을 완전히 통제할 수는 없어도, 그 방향에 의미 있는 영향을 줄 수는 있다.
뇌 역시 외부 사건을 내부 신호로 바꾸고 그중 보상과 관련된 신호를 다음 행동에 반영하는 학습 기계이며, 전대상피질(anterior cingulate cortex)에 관한 연구에서도 그 한 단면을 볼 수 있다(Hayden 외, 2011, Tervo 외, 2014).
기계에도 사람에게도 최종 보상 함수는 없다. 자신을 어떻게 설명하는지도 중요하지만, 어떤 신호가 실제로 삶을 움직이는지는 반복되는 행동에서 더 선명하게 드러난다. 배움은 들어가는 환경과 알아차리는 결과, 그다음에 선택하는 행동을 통해 계속된다. 자기 학습을 설계하는 한 사람으로서, 이제 어떻게 행동할 것인가?
2026년 9월 19일 업데이트. 이 글은 보상에서 출발해 훨씬 큰 질문으로 향한다. 지능 역시 하나의 점수로 온전히 나타내기 어려울 것이다. ‘지능적’이라는 말을 바라보는 한 가지 유용한 관점에서는 서로 다른 목표와 환경에서 시스템이 불확실성을 어떻게 줄이는지에 따라 지능을 하나의 프로필로 바라본다. 배움 자체에 관해 알아야 할 것은 여전히 많고, 배움과 지능, 의식의 관계에 관해서는 더욱 그렇다.